Transformer
En una frase: el Transformer es el diseño habitual de los grandes modelos de lenguaje.
Es el esquema interno de una red neuronal. Lo presentaron investigadores de Google en 2017.
Cómo se ve
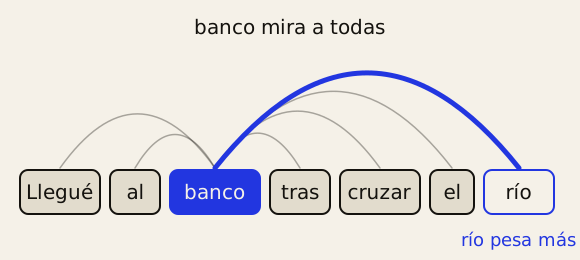
Qué pasa, paso a paso
- Cada palabra se convierte en una lista de números que representa su significado.
- Cada palabra se compara con todas las demás y puntúa cuánto le importa cada una. Eso se llama atención.
- Varias «cabezas» de atención trabajan a la vez. Cada una se fija en un tipo de relación distinto.
- Como el modelo no lee en orden, a cada palabra se le añade su posición.
- Todo esto se repite en muchas capas, una encima de otra.
- Al final, el modelo calcula qué pieza de texto es más probable que venga después.
Un ejemplo de la vida real
Imagina esta frase: «Llegué al banco después de cruzar el río».
«Banco» puede ser donde guardas dinero o la orilla de un río. Tú lo sabes por la palabra «río».
La atención hace algo parecido. Es como cuando relees una frase para saber de qué hablan. El modelo no relee: puntúa todas las palabras a la vez.
El ejemplo es de Google, en inglés (bank y river).
Por qué cambió tanto la IA
- Las redes de antes leían el texto palabra por palabra. Eso las obligaba a ir despacio.
- El Transformer trabaja con todas las palabras a la vez. Es como repartir un trabajo entre un equipo en vez de hacerlo una sola persona.
- Encaja con las tarjetas gráficas (GPU). Están hechas para hacer muchas cuentas a la vez.
- Por eso se pudieron entrenar modelos mucho más grandes.
- Tiene un precio: con el doble de texto, el trabajo se multiplica por cuatro.
Hoy también se usa con imágenes, audio y robots.
Pruébalo tú
- En «Me senté en el banco del parque», ¿qué palabra te aclara «banco»?
- ¿Por qué trabajar con todas las palabras a la vez permitió entrenar modelos más grandes?
Respuestas
- «Parque». Es la misma idea que la atención: otras palabras de la frase aclaran el significado.
- Porque las tarjetas gráficas pueden hacer muchas cuentas a la vez. Si el modelo tuviera que ir palabra por palabra, iría mucho más lento.
Palabras clave
- Red neuronal: programa formado por muchas operaciones sencillas conectadas entre sí.
- Atención: forma de puntuar cuánto le importa cada palabra a las demás.
- Modelo de lenguaje: modelo que calcula qué texto es más probable que venga después.
- Token: pieza de texto con la que trabaja el modelo, como un trozo de palabra.
- GPU: tarjeta gráfica, hecha para hacer muchas cuentas a la vez.