Revisada el 2026-10-11
En una frase: un LLM suele aprender a predecir texto y luego a ser asistente.
LLM son las siglas en inglés de «modelo de lenguaje grande». La primera fase se llama preentrenamiento: de ahí sale gran parte de lo que sabe. La segunda, el post-entrenamiento, le da la forma de asistente.
Un modelo solo preentrenado se limita a continuar texto. Seguir instrucciones de forma útil y segura es otra cosa.
Cómo se ve
En el preentrenamiento, el modelo practica una y otra vez: ¿qué token vendría después?
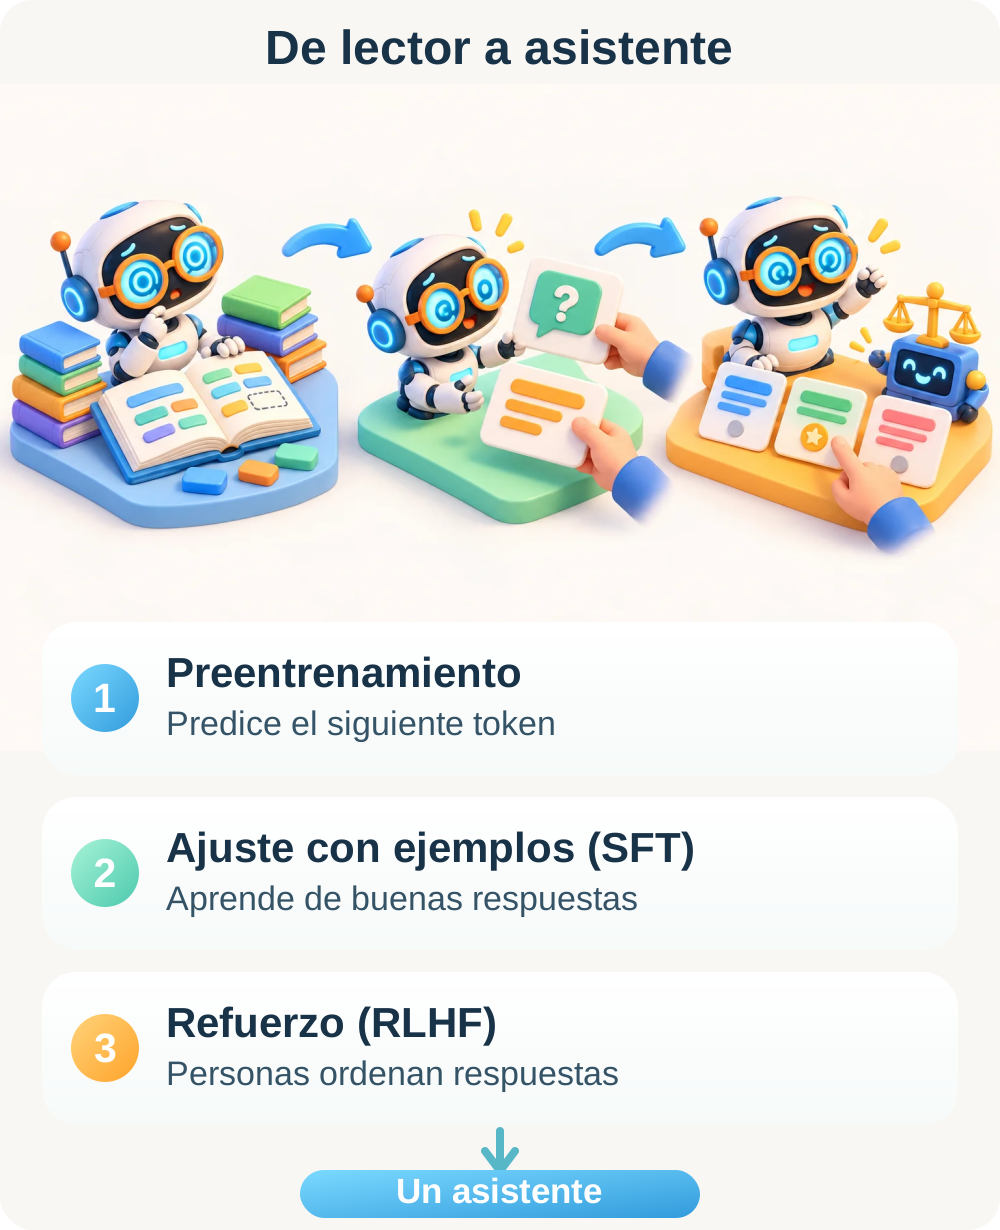
Es el esquema clásico, que popularizó OpenAI. No todos los modelos se entrenan igual.
Qué pasa, paso a paso
- Preentrenamiento. El modelo lee una cantidad enorme de texto. Su tarea es predecir el siguiente trozo de texto, o token. Nadie le pone etiquetas: la pista sale del propio texto.
- También aprende cosas en los ajustes de después. Su fecha de corte indica, más o menos, hasta cuándo llegan sus datos. No garantiza que sepa todo lo anterior.
- Ajuste con ejemplos (SFT). Se le dan peticiones y la respuesta que debería darse. En InstructGPT las escribieron personas; otros usan ejemplos creados por máquina. El modelo aprende a imitarlas. Son pocos ejemplos, así que esta fase cuesta mucho menos.
- Refuerzo con preferencias humanas (RLHF). Lo popularizó OpenAI en 2022 con InstructGPT. Unas personas ordenan varias respuestas del modelo, de mejor a peor.
- Con esas notas se entrena un segundo modelo. Hace de juez: predice qué respuesta preferiría una persona.
- Por último, el modelo practica para sacar la mejor nota posible con ese juez.
Es parecido a aprender a escribir redacciones. Primero lees muchísimos libros. Luego un profe te enseña buenos ejemplos. Al final, alguien puntúa tus textos y vas mejorando.
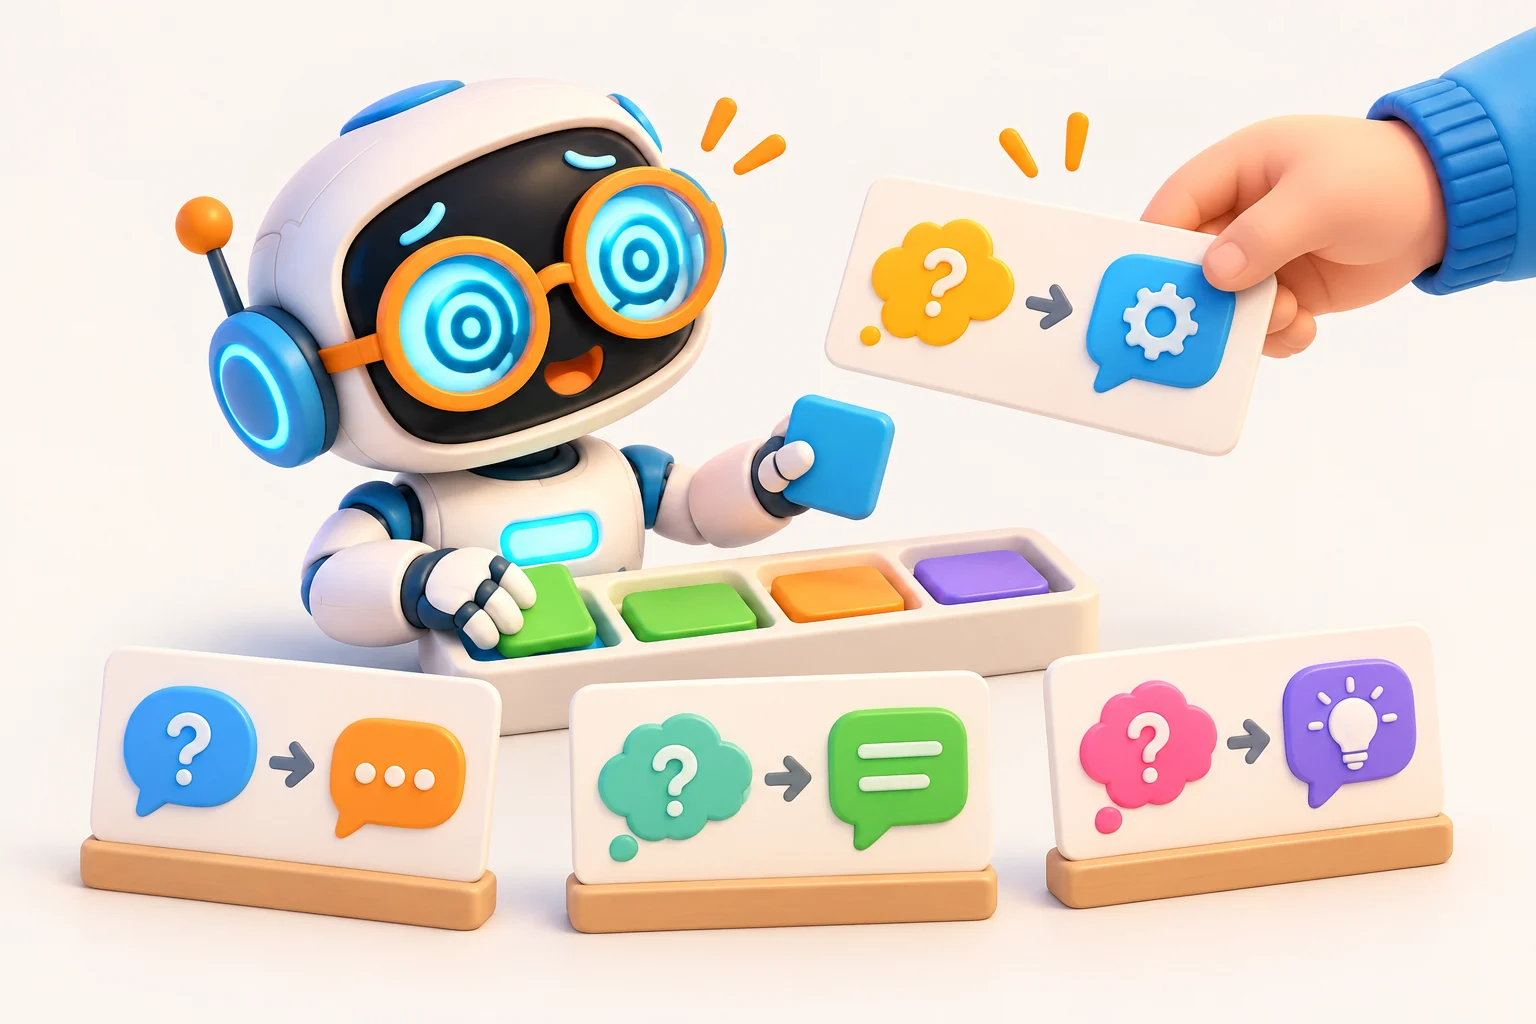
En el ajuste con ejemplos, aprende a responder peticiones viendo buenas respuestas. Los ejemplos también pueden venir de máquinas.
Un ejemplo de la vida real
Imagina que escribes a un modelo solo preentrenado: «¿Cuál es la capital de Francia?».
Podría seguir con otra pregunta, como si copiara un examen de geografía. Solo continúa el texto, como haría una página web.
Un asistente ya ajustado entiende que es una petición y te contesta: «París».
Lo que consiguió el RLHF
- Un modelo pequeño entrenado así gustaba más que GPT-3, que era cien veces más grande.
- En algunas tareas, se inventaba datos la mitad de veces que GPT-3. Aun así, seguía cometiendo errores simples.
- Tiene un límite. Aprende lo que prefiere un grupo concreto de personas. No aprende unos «valores humanos» generales.
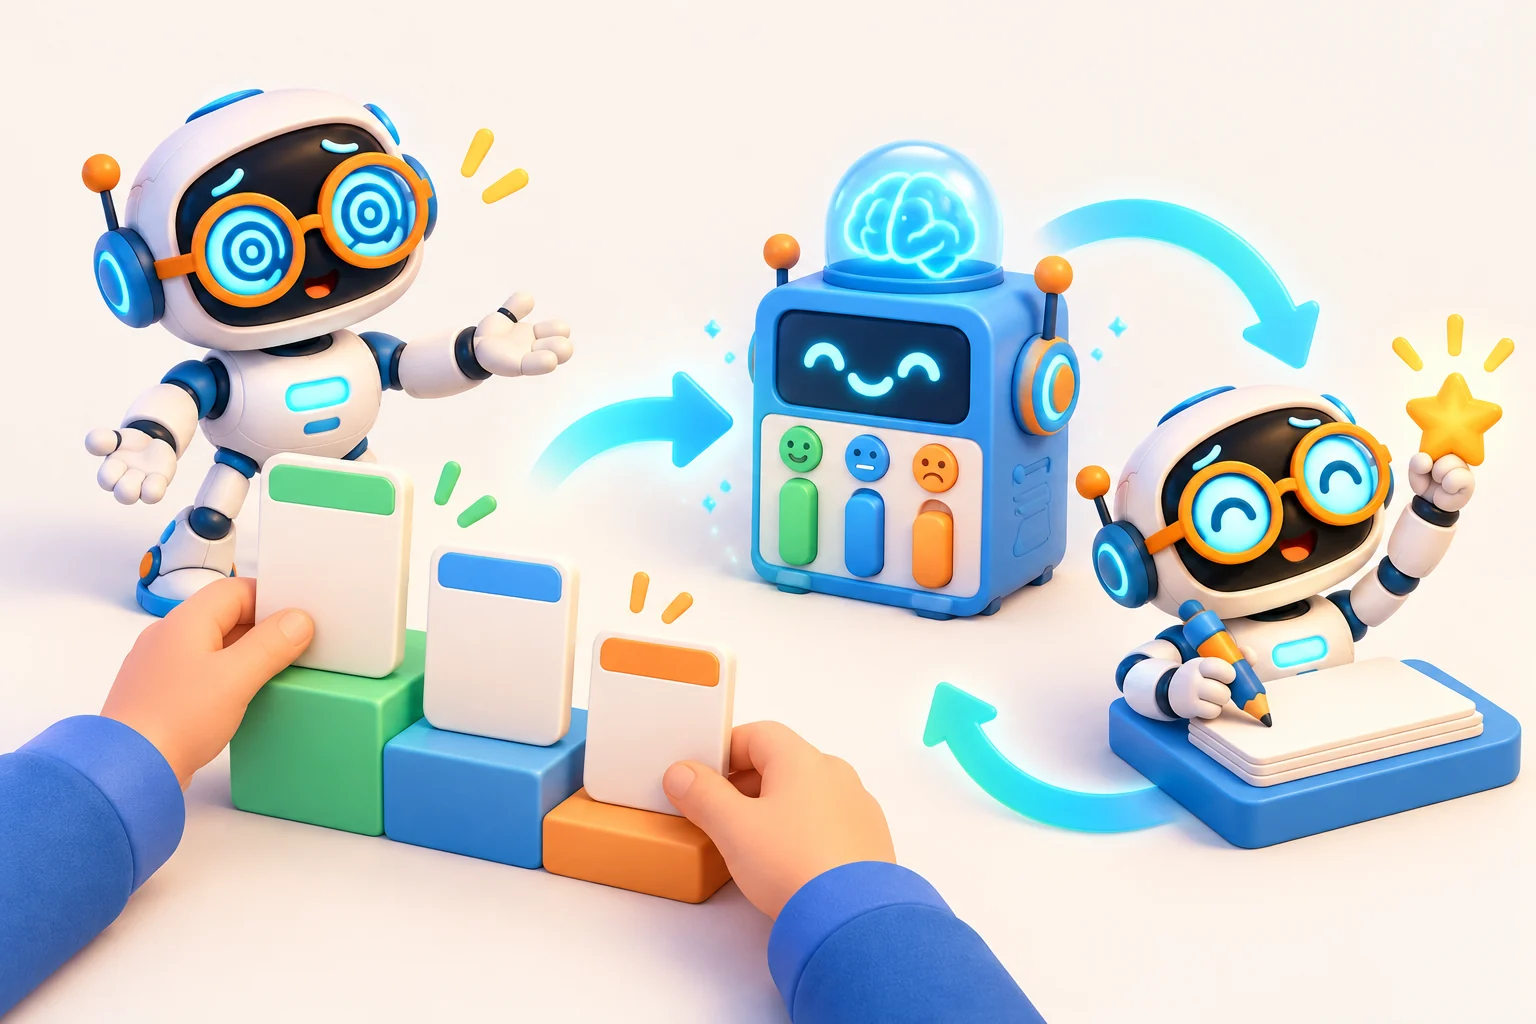
En el RLHF, las personas ordenan respuestas. Otro modelo aprende de esas notas y ayuda a mejorar la siguiente.
Otras formas de entrenar
- IA constitucional (Anthropic, 2022). En vez de muchas personas puntuando, hay una lista de principios: la «constitución». El modelo critica y corrige sus propias respuestas con ella. Después, otro modelo elige la mejor de dos respuestas, en lugar de una persona. Busca un asistente inofensivo que, si se niega, explique por qué.
- La constitución de Claude hoy. En 2026, Anthropic publicó una nueva, de uso libre. Explica el porqué de cada norma, para que el modelo sepa actuar en casos nuevos. Mantiene reglas fijas para lo más peligroso. Claude la usa para crear ejemplos de entrenamiento.
- DPO (2023). Parte de que el RLHF es complicado y a menudo inestable. Resuelve el mismo problema con un método más sencillo.
- Refuerzo para razonar. DeepSeek-R1-Zero (2025) empezó a razonar solo con refuerzo, sin el ajuste con ejemplos. DeepSeek-R1 añadió ejemplos de arranque y más rondas de refuerzo. Así sus respuestas se leen mejor y son más útiles. No son la misma receta.
Por qué importa
- La fecha de corte orienta, pero no es un muro. Para comprobar datos de hoy, dale fuentes en la conversación o usa búsqueda.
- Explica su carácter. El tono, las negativas explicadas y el cuidado con lo dañino salen del ajuste.
- Ayuda a entender las noticias. «Más datos», «más refuerzo» o «nueva constitución» hablan de fases distintas.
- El ajuste reduce los inventos, pero no los elimina. Por eso la wiki pide una fuente para cada dato.
Pruébalo tú
- Un modelo sin búsqueda no sabe quién ganó un partido la semana pasada. ¿Qué fase lo explica?
- ¿En qué se diferencian el ajuste con ejemplos y el refuerzo con preferencias?
Respuestas
- El preentrenamiento. Sus datos llegan, más o menos, hasta su fecha de corte. El partido fue después.
- En el ajuste, el modelo imita respuestas escritas por personas. En el refuerzo, las personas ordenan respuestas del propio modelo, y él aprende de esas notas.
Palabras clave
- Preentrenamiento: primera fase, en la que el modelo lee muchísimo y aprende a predecir texto.
- Fecha de corte: hasta cuándo llegan, más o menos, los datos con los que aprendió.
- SFT: ajuste con ejemplos de peticiones y de buenas respuestas.
- RLHF: refuerzo con las preferencias de personas que ordenan respuestas.
- Refuerzo: aprender probando y recibiendo una nota por cada intento.
- Constitución: lista de principios que guía cómo debe comportarse el modelo.