Revisada el 2026-10-10
En una frase: un benchmark es una prueba que puntúa modelos de IA.
Sirve para comparar modelos, pero una cifra suelta puede engañar. Mira qué mide, quién la midió y cómo.
Las pruebas pueden contaminarse o saturarse. Las votaciones traen sesgos de preferencia. Por eso conviene cruzar fuentes y medir tareas propias.
Cómo se ve
Qué pasa, paso a paso
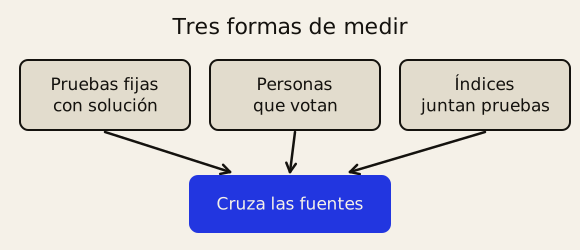
- Pruebas fijas: un banco de preguntas con solución conocida. Es como un examen con plantilla de corrección. Las hay de ciencia, de matemáticas y de resolver problemas reales de programación.
- Arena: dos modelos anónimos responden a la misma pregunta. Tú votas y solo después ves sus nombres.
- Con los votos se calcula una puntuación, parecida al Elo del ajedrez. Hay clasificaciones por categoría: texto, imagen, vídeo y otras.
- Control de estilo: a la gente le gustan las respuestas largas y vistosas. Arena lo tiene en cuenta en el cálculo.
- Índices: juntan muchas pruebas en una sola nota. El de Artificial Analysis reúne diez pruebas en cuatro bloques. Son agentes, programación, conocimiento general y razonamiento científico.
Un ejemplo de la vida real
Imagina que dos apps dicen ser «la mejor». Una presume de una prueba de matemáticas. La otra, de votos de personas. No miden lo mismo. Por eso conviene cruzar fuentes de tipos distintos.
En la guía Mejor modelo para cada tarea verás cómo se hace.
Qué puede fallar
- Contaminación: si las preguntas estaban en los datos de entrenamiento, la nota sale inflada. Es como ver el examen antes de hacerlo.
- Saturación: cuando casi todos sacan la máxima nota, la prueba ya no distingue. Epoch AI ha añadido una prueba más difícil.
- Condiciones de medida: pequeños cambios en la pregunta o en los ajustes mueven el resultado. En los modelos que razonan, el nivel de esfuerzo puede cambiar el resultado. Importa con cuál se midió.
- Selección interesada: un artículo de 2025 sostiene que algunos laboratorios prueban muchas versiones en privado. Solo publicarían la mejor. Arena respondió que el artículo contiene afirmaciones incorrectas.
- Margen de error: una diferencia pequeña puede ser ruido.
- Modelo o arnés: en pruebas de agentes, también cuenta el programa que rodea al modelo.
Qué mirar antes de fiarte
- Qué mide: una puntuación de matemáticas no acredita por sí sola que redacte bien.
- Quién la midió: la empresa que vende el modelo o alguien independiente.
- Con qué ajustes: esfuerzo, número de intentos y herramientas.
- Qué versión: los índices cambian de composición varias veces al año.
- Si la prueba está saturada o se pudo filtrar al entrenamiento.
- Cuántos votos hay detrás, en el caso de Arena. Una diferencia pequeña no basta para declarar un ganador.
Pruébalo tú
- Una app presume de una nota altísima en matemáticas. ¿Sabes ya si redacta bien?
- ¿Por qué Arena enseña los nombres de los modelos solo después de votar?
Respuestas
- No. Una nota de matemáticas no acredita por sí sola que redacte o programe bien.
- Para que el voto no dependa de la marca. Los votos emitidos tras ver los nombres no cuentan.
Palabras clave
- Benchmark: prueba estandarizada que puntúa modelos de IA para poder compararlos.
- Arena: web donde las personas votan entre dos modelos anónimos.
- Contaminación: las preguntas de la prueba estaban en los datos de entrenamiento.
- Saturación: casi todos los modelos rozan la nota máxima y la prueba no distingue.
- Arnés: el programa que rodea al modelo y le da herramientas.