Mejor modelo para cada tarea
En una frase: no hay un modelo mejor para todo.
Depende de la tarea. La guía adulta usa pruebas independientes y datos oficiales. También dice qué puede concluirse de cada prueba y qué no.
Un primer puesto mide el resultado de una prueba. No garantiza el mejor resultado con tus archivos, en español o dentro de una app. Los nombres y las cifras cambian muy rápido, así que aquí no van.
Cómo se ve
La tabla de la guía
- Cada fila es una tarea. Hay inteligencia general, texto, desarrollo web, documentos, imágenes, vídeo y pesos abiertos.
- Cada fila dice quién lidera, quién va después y de dónde sale el dato.
- Cada fila indica también el límite de la prueba. Un texto no prueba la redacción en español.
- Una columna mide inteligencia y coste en una batería de pruebas. Otra recoge votos de personas.
- Esas dos medidas no se suman. Tampoco dan un único ganador.
- Algunos puestos llevan la marca «preliminar». Mira también el margen de error de cada puesto.
Qué pasa, paso a paso
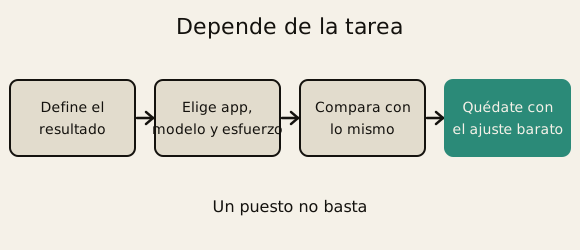
- Define el resultado que buscas y cómo lo vas a comprobar. Por ejemplo, con fuentes verificadas o con pruebas del programa.
- Elige dónde lo vas a usar. Separa la app, el modelo y el nivel de esfuerzo. Son tres cosas distintas.
- Compara los candidatos con las mismas preguntas y los mismos criterios.
- Una guía de un fabricante es su recomendación. No demuestra que gane a los de otras empresas.
- Quédate con el ajuste menos costoso que cumpla tus criterios. Mide también el tiempo y las correcciones.
- Los nombres de los niveles, como alto o máximo, no equivalen entre modelos.
Un ejemplo de la vida real
Quieres ayuda para programar una web. En una clasificación de desarrollo web, un modelo grande de Anthropic va primero. Uno más pequeño de la misma familia queda tercero.
Eso no basta para elegir. Haz la misma tarea con los dos y compara. Mira cuál acierta más y cuánto tarda.
Para imágenes y vídeo hay clasificaciones aparte. Cada una tiene sus propios límites. Son datos de octubre de 2026 y pueden haber cambiado.
Modelos y versiones vigentes
- Cada laboratorio tiene modelos grandes, medianos y pequeños. Los grandes dan más calidad. Los pequeños son más rápidos y baratos.
- La guía adulta recoge la versión actual de cada uno. Cambia varias veces al año, así que mejor mirarla allí.
- El orden de esa tabla no es un ranking de calidad.
- Un modelo nuevo puede no estar abierto al público todavía. Uno de Google figura en la clasificación de texto, pero su acceso sigue restringido.
- Algunos servicios se cierran. Los modelos de vídeo Sora, de OpenAI, ya están retirados.
- Un modelo puede estar en una app y no en otra. Por eso conviene separar app, modelo y esfuerzo.
- Muchos modelos tienen niveles de esfuerzo. Cambiarlos puede alterar la velocidad y el consumo. El máximo no siempre mejora el resultado.
- «Gratis (descarga)» se refiere solo al modelo. Ejecutarlo cuesta equipo y electricidad.
Suscripciones en España
- Los grandes asistentes tienen plan gratis y planes de pago.
- Los planes suben en uso y en funciones. El acceso depende del plan y de la app.
- Los precios están en la ficha adulta, cada uno en su moneda. Cambian y no se convierten.
- Contratar un plan es cosa de un adulto.
- La comparativa de asistentes está en Asistentes de chat.
A tener en cuenta
- Un primer puesto puede ser preliminar. Pasa con modelos que aún no están abiertos al público.
- Que un modelo falte en una clasificación no demuestra que rinda peor.
- El coste de una prueba no es el precio de tu uso. Tampoco el de una suscripción.
- El coste real depende del nivel de esfuerzo elegido, no solo del precio por token.
- Para redactar en español, compara ejemplos propios. La wiki no ha medido qué configuración funciona mejor en ese idioma.
Pruébalo tú
- ¿Por qué un primer puesto no basta para elegir modelo?
- ¿Qué tres cosas conviene separar al elegir?
Respuestas
- Porque mide el resultado de una prueba. No garantiza el mejor resultado en tus archivos ni en tu app.
- La app, el modelo y el nivel de esfuerzo.
Palabras clave
- Modelo: el programa de IA que genera las respuestas.
- Nivel de esfuerzo: cuánto «piensa» el modelo antes de responder.
- Modelo abierto: modelo cuyos pesos se pueden descargar.
- Clasificación: lista que ordena modelos según pruebas o votos.
- Preliminar: puesto con pocos votos, que puede cambiar.