Ventana de contexto
En una frase: es lo máximo que un modelo puede tener a la vista al responder.
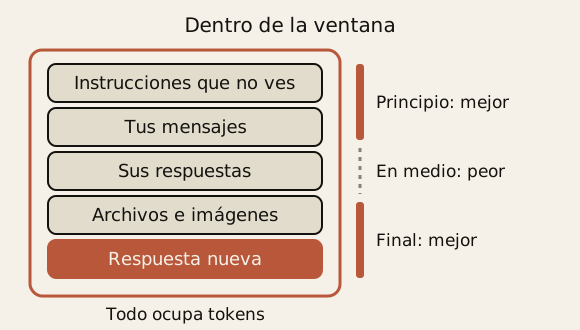
Incluye la conversación, los archivos y también la respuesta que está escribiendo. Se mide en tokens, los trozos de texto con los que trabaja el modelo. Funciona como una memoria de trabajo: no es lo que aprendió al entrenarse.
Es como tu mesa de estudio. Solo tienes a mano lo que está encima, aunque sepas muchas más cosas.
Que quepa más no significa que funcione mejor. Con mucho texto, puede encontrar y relacionar peor la información. Depende del modelo y de la tarea.
Cómo se ve
Cuánto cabe
- Depende del modelo. Las cifras exactas cambian a menudo y la versión adulta solo da las de Claude.
- Los modelos de Claude más recientes aguantan textos muy largos. Algunos anteriores, bastante menos.
- Para comparar con otros laboratorios, mira Mejor modelo para cada tarea.
- No hay una cifra fija de palabras por token. Depende del idioma y del texto.
- Para comparar, el pequeño GPT-2 solo veía unos 1.000 tokens. Hoy caben muchísimos más.
Qué pasa, paso a paso
- Cuenta todo lo que se envía: instrucciones, mensajes, archivos, imágenes y resultados de herramientas. La respuesta, con lo que razona, también cuenta.
- En cada turno, la app envía tu mensaje nuevo y el historial que quiera guardar. Puede mandarlo entero, resumido o solo lo importante.
- Si lo que envías ya no cabe, el programa da un error. En los modelos recientes, la respuesta que no cabe se corta al llegar al límite.
- Algunos chats van retirando lo más antiguo para hacer sitio. Es como tu mesa: para poner algo nuevo, quitas lo que lleva más tiempo.
- En un Transformer, el diseño de estos modelos, cada token mira a todos los demás. Con el doble de texto, hay cuatro veces más trabajo. Que rinda peor con textos largos se ha visto en pruebas. No sale solo de esa cuenta.
Un ejemplo de la vida real
Llevas toda la tarde en el mismo chat. Al principio le contaste de qué iba tu trabajo de clase. Ahora parece que se le ha olvidado.
No se ha cansado. La conversación es tan larga que lo antiguo puede haberse salido de la ventana. O se pierde entre tanto texto.
Lo práctico: empieza un chat nuevo para cada tarea. Si necesitas seguir con la misma, pega antes un resumen corto de lo importante.
Por qué importa
- En pruebas, añadir mucho texto puede hacer que recuerde y acierte menos. Es la degradación del contexto. Cambia de un modelo a otro. Que algo quepa no garantiza que lo use bien.
- La posición importa. En pruebas con textos largos, lo del principio y lo del final se usaba mejor. Lo del medio, mucho peor.
- Hay tres formas de no llenarla: resumir y reiniciar, guardar notas fuera o usar ayudantes. Los ayudantes, llamados subagentes, hacen una parte y solo devuelven un resumen. A todo esto se le llama ingeniería de contexto.
- Las novedades de cada modelo y lo que cuesta usarlo están en la versión adulta.
Ahorrar espacio y dinero
Hay trucos para que quepa lo necesario y para pagar menos.
- Deja solo lo necesario. Resume lo largo, guarda notas fuera y usa ayudantes que devuelvan un resumen.
- Al cambiar de tarea, empieza otra conversación. Si sigues con la misma, resume lo hecho.
- Pon lo que no cambia al principio y lo nuevo al final. Así se reutiliza lo ya leído; eso se llama caché. Abarata lo repetido, pero no libera sitio en la ventana.
- Elige el modelo y cuánto razona según la tarea.
- Lo que no corre prisa puede salir más barato si se envía por lotes. No todos los servicios lo ofrecen igual.
- Mide antes de ahorrar: cuántos tokens entran, cuántos salen y cuántos se reutilizan.
Los detalles de cada herramienta y sus precios están en la versión adulta. Es material para quien programa.
Pruébalo tú
- En un chat muy largo, ¿por qué el modelo puede olvidar lo del principio?
- Vas a cambiar de tarea. ¿Qué te conviene hacer y por qué?
Respuestas
- Porque lo antiguo puede salirse de la ventana. Y aunque quepa, con tanto texto el modelo puede aprovecharlo peor.
- Empezar un chat nuevo. Así la conversación vieja no ocupa sitio en la ventana.
Palabras clave
- Token: pieza de texto con la que trabaja el modelo, como un trozo de palabra.
- Memoria de trabajo: lo que se tiene a mano mientras se hace una tarea.
- Degradación del contexto: el modelo puede rendir peor cuando tiene mucho texto a la vista.
- Caché: copia de lo ya leído para no procesarlo otra vez.
- Subagente: ayudante que hace una parte del trabajo y devuelve solo un resumen.