Modelos de razonamiento y nivel de esfuerzo
En una frase: algunos modelos piensan antes de responder; el nivel de esfuerzo orienta cuánto.
Pensar antes ayuda en lo difícil: matemáticas, programar o tareas largas. Pero tarda más y cuesta más, aunque ese pensamiento no lo veas.
Anthropic, OpenAI y Google lo regulan con un ajuste de esfuerzo.
Cómo se ve
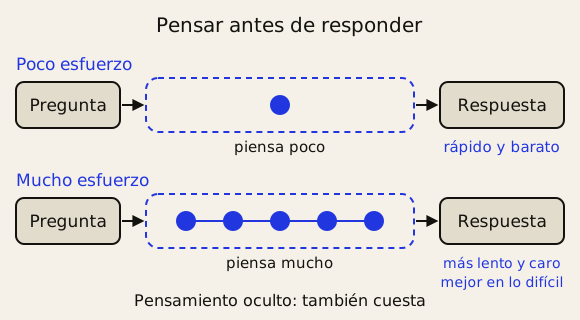
De dónde viene
En 2022 se probó un truco: dar al modelo ejemplos resueltos paso a paso. Los modelos grandes razonaban mejor así. Uno logró el mejor resultado de su época en problemas de matemáticas.
A esos pasos escritos se les llama cadena de pensamiento.
En 2024, OpenAI presentó un modelo entrenado para usar bien su cadena de pensamiento. Lo entrenaron con refuerzo: probar, recibir una puntuación y mejorar. Es como subir de nivel en un videojuego, partida a partida.
Rinde más cuanto más refuerzo recibe y cuanto más tiempo piensa al responder. El refuerzo se explica en Cómo se entrena un LLM.
Qué pasa, paso a paso
- Le haces una pregunta difícil.
- Antes de responder, el modelo hace un trabajo intermedio: piensa.
- No tiene que pensarlo todo al principio. También puede pensar entre una herramienta y otra.
- Ese pensamiento no lo ves entero. Como mucho, un resumen; en los modelos actuales, por defecto ni eso.
- Al final escribe la respuesta. Todo lo que pensó cuenta como parte de la respuesta. También cuesta, aunque no lo veas.
Es como el papel de sucio de un examen. Haces ahí las cuentas y entregas solo el resultado.
Algunos modelos deciden solos cuándo y cuánto pensar. Se llama pensamiento adaptativo.
Un ejemplo de la vida real
Piensa en dos deberes. Uno es copiar una lista de palabras. Otro es un problema de matemáticas con varios pasos.
Para copiar no hace falta pensar mucho: ir más despacio no lo mejora. Para el problema, sí compensa pararse a pensar.
Con un modelo pasa igual. Esfuerzo bajo para lo sencillo; alto para lo complejo.
El nivel de esfuerzo
- Es un ajuste con varios niveles, de bajo a máximo. Afecta a toda la respuesta: texto, herramientas y pensamiento.
- No es un tope, es una señal. Con poco esfuerzo, ante algo difícil, el modelo sigue pensando, pero menos.
- Con menos esfuerzo usa menos herramientas y explica menos. Con más, cuenta su plan y resume con detalle.
- Anthropic da una guía. Bajo para lo sencillo; medio para equilibrar rapidez y coste. Alto para lo complejo, y el máximo solo para lo más difícil.
- En algunos modelos el pensamiento no se puede apagar. Ahí el esfuerzo es el mando principal.
En Claude Code
Claude Code es un asistente para programar. Allí el esfuerzo se cambia con una orden escrita y queda guardado.
También hay una palabra que pide pensar más solo en esa petición. El detalle está en la ficha adulta.
En otras empresas
- OpenAI tiene un ajuste parecido. Su pensamiento no se ve. Algunos modelos dan un resumen, que no es el pensamiento completo. Ocupa espacio y cuesta como la respuesta.
- En Google, por defecto, el modelo decide cuánto pensar. Ese pensamiento también cuesta como la respuesta.
Por qué importa
- Pensar tarda y cuesta, aunque no se vea. En una tarea sencilla, mucho esfuerzo puede gastar más sin mejorar nada. Conviene probar con ejemplos propios.
- Más no siempre es mejor. El nivel máximo puede pensar de más en tareas sencillas o muy ordenadas.
- Es el gran salto reciente. Epoch AI tiene un índice que mide lo que saben hacer los mejores modelos. Desde 2024, los que razonan avanzan más del doble de rápido que el resto.
- La ficha Acelerar Cline parte de la misma idea: mucho razonamiento, agente lento. Sus datos están sin contrastar.
Pruébalo tú
- Tienes que pasar a mayúsculas una lista de nombres. ¿Pondrías el esfuerzo alto o bajo?
- Si no ves lo que piensa el modelo, ¿por qué también cuesta?
Respuestas
- Bajo. Es una tarea sencilla y mecánica: más esfuerzo podría gastar más sin mejorar el resultado.
- Porque el modelo sí escribe ese pensamiento, aunque no te lo enseñe. Cuenta como parte de la respuesta.
Palabras clave
- Modelo de razonamiento: modelo que escribe pasos de pensamiento antes de responder.
- Nivel de esfuerzo: ajuste que indica cuánto debe pensar el modelo.
- Cadena de pensamiento: los pasos intermedios que llevan a una respuesta.
- Refuerzo: forma de entrenar en la que el modelo prueba y recibe una puntuación.
- Pensamiento adaptativo: el modelo decide solo cuándo y cuánto pensar.