Modelo de lenguaje (LLM)
En una frase: es un programa que predice, pieza a pieza, cómo sigue un texto.
LLM son sus siglas en inglés: «modelo de lenguaje grande». Por dentro es una red neuronal que ha leído muchísimo texto. Es la pieza que hay debajo de los chatbots actuales, como Claude.
Escribe con lo que aprendió y con lo que le das en el chat. La app que lo usa puede añadirle búsqueda y memoria.
Cómo se ve
Qué pasa, paso a paso
- Primero trocea el texto en tokens: palabras, trozos de palabra o letras sueltas.
- Al entrenarse, una tarea habitual es predecir el token siguiente. Hay otras, como adivinar palabras tapadas. No todos los modelos se entrenan igual.
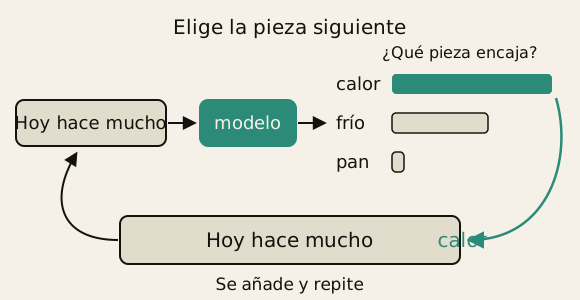
- Al escribir, calcula la probabilidad de cada token posible. Elige uno, lo añade y repite con el siguiente.
- La temperatura decide cuánto se arriesga al elegir. Alta da respuestas más variadas; baja, más previsibles. Ni con la temperatura al mínimo sale siempre lo mismo.
- Casi siempre usa por dentro un diseño llamado Transformer. Los modelos tipo GPT usan solo una parte de él.
- Recién entrenado no sabe seguir instrucciones. Luego se ajusta con ejemplos y valoraciones de personas para que actúe como asistente. Claude, por ejemplo, ya ha pasado por ese ajuste.
Es como el autocompletar del teclado del móvil, pero muchísimo más potente.
Un ejemplo de la vida real
Escribe en un chat: «Érase una vez un dragón que…».
El modelo no busca ese cuento en ningún sitio. Calcula qué pieza encaja mejor, la añade y sigue. Si lo pides dos veces, puede salir un cuento distinto.
Como elige lo que mejor encaja, escribe con soltura. Pero a veces se equivoca con total seguridad.
Lo que no es
- No es una base de datos. No guarda datos en fichas: aprende patrones del texto.
- Si no distingue lo cierto de lo falso, se equivoca. Pasa sobre todo con datos raros, como el cumpleaños de alguien poco conocido. A eso se le llama alucinación.
- Para entrar en internet necesita herramientas. Cada modelo tiene una fecha de corte: hasta cuándo llegan, más o menos, sus datos. Tampoco sabe todo lo anterior a esa fecha.
- Para datos de hoy necesita una herramienta de búsqueda, que le da la aplicación. Con ella decide cuándo buscar y cita las fuentes.
- Hablar con él no cambia lo que aprendió. El chat y lo que la app recuerde deben entrar en su ventana de contexto.
- La memoria y las herramientas se las añade el programa que lo rodea. Ese programa se llama arnés.
Por qué importa
- Explica sus errores. Está hecho para continuar el texto de forma creíble. Un estudio de OpenAI añade otra causa. Muchos exámenes de IA premian adivinar antes que decir «no lo sé». Así, la costumbre de adivinar puede seguir después del ajuste.
- Explica sus límites. Lo que lee, lo que escribe y lo que le cabe se mide en tokens. También lo que cuesta usarlo.
- Explica por qué el mismo modelo funciona distinto en cada aplicación. La memoria, la búsqueda y las acciones las pone el arnés, no el modelo.
- Da contexto histórico. El Transformer llegó en 2017 y GPT-1, en 2018. ChatGPT, lanzado a finales de 2022, hizo populares estos modelos.
Pruébalo tú
- El modelo solo no entra en internet. ¿Cómo puede saber qué pasó ayer?
- ¿Por qué tiende a inventarse el cumpleaños de alguien poco conocido?
Respuestas
- Porque la aplicación le da una herramienta de búsqueda. Con ella encuentra datos actuales y cita las fuentes. Sin esa herramienta, solo cuenta con lo que aprendió al entrenarse.
- Porque ese dato sale muy pocas veces en los textos con los que aprendió. Como no lo distingue de uno falso, escribe uno que suene creíble.
Palabras clave
- Red neuronal: programa formado por muchas operaciones sencillas conectadas entre sí.
- Token: pieza de texto con la que trabaja el modelo, como un trozo de palabra.
- Temperatura: ajuste que decide cuánto se arriesga el modelo al elegir la pieza siguiente.
- Fecha de corte: hasta cuándo llegan, más o menos, los datos con los que aprendió.
- Ventana de contexto: lo que el modelo tiene a la vista en la conversación.
- Arnés: programa que rodea al modelo y le añade memoria y herramientas.