RAG y el patrón LLM Wiki
En una frase: RAG busca información en documentos y la pasa al modelo para responder.
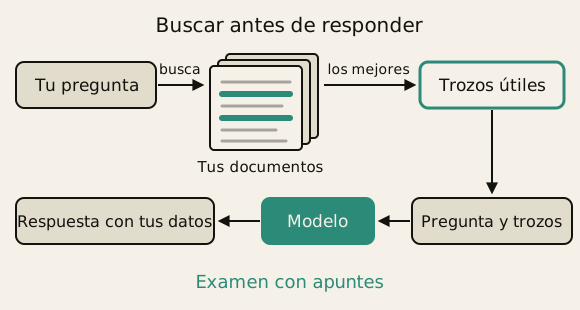
RAG son siglas en inglés: generación aumentada por recuperación. Primero se busca y luego el modelo escribe. Así responde con tus datos, no solo con lo que recuerda.
Hay otra vía, la LLM Wiki. Un agente ordena tus fuentes una vez en una wiki y la mantiene al día.
Y si tienes pocos documentos, a veces lo mejor es dárselos enteros.
Cómo se ve
Qué pasa, paso a paso
- Tus documentos se cortan en trozos pequeños (fragmentos), de unos pocos párrafos.
- Cada trozo se convierte en una lista de números que resume su significado. Se llama embedding.
- Así se busca por sentido. Sale un trozo que habla de lo mismo, aunque use otras palabras.
- A la vez, otro índice busca las palabras exactas. Se juntan los resultados de las dos búsquedas.
- Los mejores trozos se añaden a tu pregunta. El modelo responde con ellos delante.
Es como un examen con apuntes: antes de contestar, buscas la página del tema.
De dónde viene
La idea se publicó en 2020, en un artículo de Lewis y otros investigadores. Juntaba dos memorias: lo que el modelo aprendió al entrenarse y un buscador sobre Wikipedia.
Sus respuestas eran más concretas y fieles a los hechos que las del modelo solo.
El punto débil: trozos sin contexto
Al cortar el texto, cada trozo pierde contexto. Y entonces la búsqueda falla.
Anthropic pone este ejemplo: un trozo dice «los ingresos crecieron un 3 %». ¿De qué empresa? ¿Cuándo? El trozo no lo dice.
Es como una hoja suelta que dice «ganó 3 a 1». ¿Quién? ¿Qué partido?
Un arreglo: dar contexto a cada trozo
- En 2024, Anthropic propuso un arreglo. Antes de guardar cada trozo, un modelo le añade una nota breve. La nota lo sitúa en su documento.
- En las pruebas que publicó Anthropic, los fallos al buscar bajaron mucho. Si además se reordenan los resultados, bajaron unos dos tercios.
- Ojo: esas cifras miden fallos al buscar, no si la respuesta final acierta.
- Si tus documentos caben en la ventana de contexto, Anthropic propuso dárselos enteros al modelo. Es una opción que hay que probar, no una regla fija. Hay que mirar cuánto cuesta y si responde bien.
- Los proyectos de Claude activan RAG solos cuando tienen demasiados documentos. Así les caben muchos más.
La LLM Wiki: ordenar una vez
- La propuso Andrej Karpathy en 2026. Es un texto con la idea, pensado para dárselo a un agente. El agente construye la wiki con él.
- Su crítica a RAG: el modelo vuelve a descubrirlo todo en cada pregunta. En la wiki, lo que sabe se escribe una vez y se va acumulando.
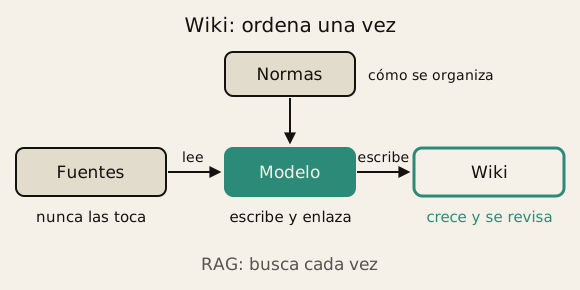
- Tiene tres capas. Las fuentes originales, que el modelo lee y nunca toca. La wiki, que el modelo escribe y mantiene. Y unas normas que dicen cómo se organiza todo.
- Tres tareas: añadir fuentes, consultar y revisar. Una fuente nueva puede cambiar muchas páginas a la vez.
- Al consultar, las buenas respuestas se guardan como páginas nuevas. Al revisar, se buscan contradicciones, datos viejos y enlaces que faltan.
- Usa dos archivos clave. Un índice, con una línea por cada página. Y un registro de cambios, en el que solo se añade al final.
Es como pasar los apuntes a limpio en vez de rebuscar cada día.
Con unas 100 fuentes basta el índice. Si crece mucho más, Karpathy propone añadir un buscador.
Cuál elegir
- Pocos documentos, que caben y funcionan bien en la ventana: prueba a dárselos enteros.
- Muchos documentos que no caben: prueba RAG, con el arreglo de los trozos con contexto.
- Algo que quieres ampliar, revisar y enlazar durante meses: LLM Wiki.
- Preguntar a tus fuentes sin montar nada: una herramienta hecha, como Gemini Notebook.
Gemini Notebook responde solo con tus fuentes y señala los trozos que usa. Su ayuda no explica cómo los busca por dentro.
La wiki y RAG se pueden combinar. El buscador puede mirar en las fuentes y también en la wiki.
Ninguno garantiza acertar. Encontrar un trozo no asegura que respalde bien la respuesta.
RAG tampoco es infalible. En las pruebas de Anthropic, la versión básica fallaba a veces. No encontraba el trozo correcto unas 6 de cada 100 veces. Lee también Alucinaciones.
Un ejemplo de la vida real
Con ayuda de un adulto, puedes subir tu libro de Ciencias a Gemini Notebook. Le preguntas qué es la fotosíntesis. Te responde solo con tu libro y te dice de qué trozo lo saca.
Libros escolares en Gemini Notebook explica cómo digitalizar un libro para estudiar con él.
Otro ejemplo: la Wiki de IA, de donde sale esta ficha, sigue la LLM Wiki.
Pruébalo tú
- Quieres preguntarle cosas a un asistente sobre un cuento de 10 páginas. ¿Necesitas RAG?
- Un trozo dice «ganó 3 a 1». ¿Por qué puede fallar la búsqueda?
Respuestas
- Probablemente no. Si el cuento cabe en la ventana de contexto, puedes probar a dárselo entero al modelo.
- Porque ha perdido el contexto: no dice quién ganó ni qué partido. El arreglo es añadir a cada trozo una nota que lo sitúe.
Palabras clave
- RAG: buscar trozos de tus documentos y dárselos al modelo antes de que responda.
- Fragmento: trozo pequeño de un documento.
- Embedding: lista de números que resume el significado de un texto.
- LLM Wiki: wiki que un modelo escribe con tus fuentes y mantiene al día.
- Ventana de contexto: cuánto texto puede tener el modelo a la vista a la vez.